Hệ thống phân tán và tích hợp hệ thống: Những vấn đề chỉ xuất hiện khi phần mềm bắt đầu giao tiếp với nhau
Hệ thống phân tán, hệ thống tích hợp. Tưởng đối lập nhưng lại đồng hành cùng nhau.
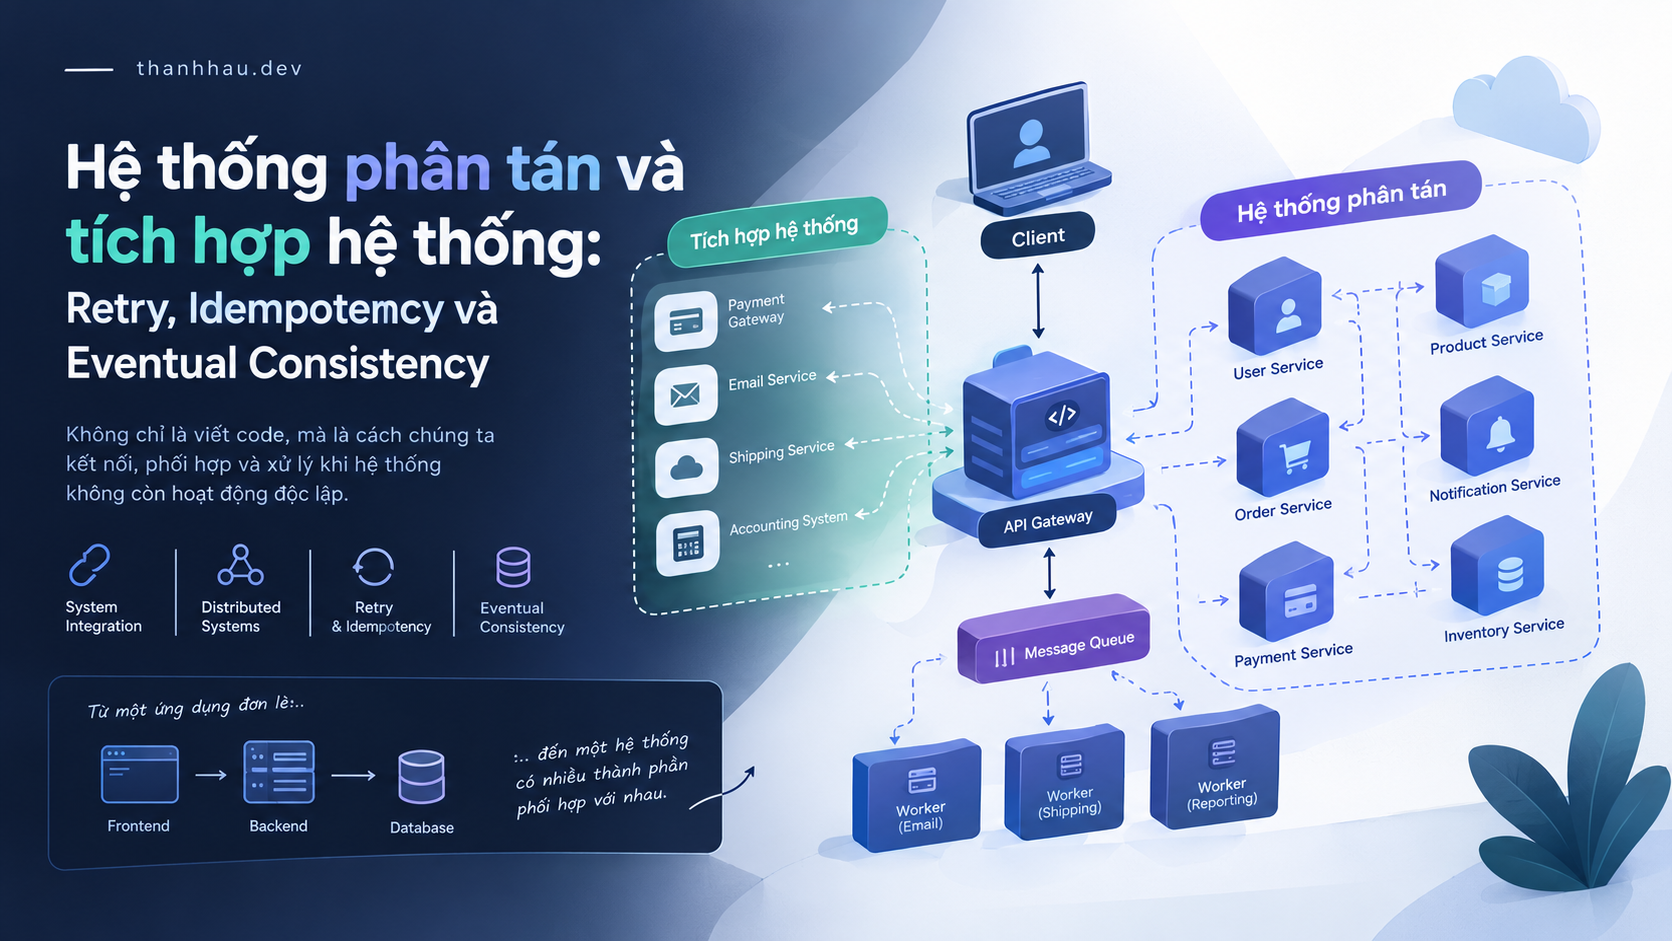
Khi mới phát triển một ứng dụng web cơ bản, phần lớn những vấn đề chúng ta quan tâm nằm bên trong ứng dụng: tổ chức code, thiết kế database, xử lý nghiệp vụ, tối ưu API và triển khai lên server.
Nhưng khi làm việc với những hệ thống có nhiều thành phần hơn, tôi nhận ra rằng một phần đáng kể độ phức tạp không còn nằm trong từng ứng dụng riêng lẻ, mà xuất hiện ở ranh giới giữa chúng.
Một API có thể hoạt động đúng trong môi trường phát triển nhưng vẫn phát sinh vấn đề khi kết nối với hệ thống bên ngoài. Một giao dịch có thể đã được xử lý ở phía đối tác nhưng ứng dụng của chúng ta không nhận được phản hồi. Một tác vụ nền có thể được đưa vào hàng đợi thành công nhưng chưa chắc đã được xử lý. Hai hệ thống đều hoạt động bình thường nhưng dữ liệu giữa chúng vẫn có thể không đồng nhất tại một thời điểm.
Đây là những tình huống khiến tôi quan tâm nhiều hơn đến hai chủ đề: Distributed Systems và System Integration.
Tôi chưa xem đây là những lĩnh vực có thể nắm vững chỉ bằng việc đọc một vài tài liệu hay triển khai một dự án mẫu. Nhưng càng tiếp xúc với backend, DevOps và các hệ thống có nhiều thành phần, tôi càng thấy việc hiểu những nguyên tắc nền tảng của chúng là cần thiết.
Bài viết này tập trung vào cách tôi phân biệt hai khái niệm, những vấn đề kỹ thuật liên quan và cách tiếp cận chúng khi xây dựng phần mềm.
1. System Integration và Distributed Systems không phải cùng một khái niệm
Hai khái niệm này có phần giao nhau, nhưng xuất phát từ hai góc nhìn khác nhau.
System Integration tập trung vào việc kết nối các hệ thống để trao đổi dữ liệu và phối hợp thực hiện nghiệp vụ. Những hệ thống được kết nối có thể được phát triển độc lập, sử dụng công nghệ khác nhau hoặc do những tổ chức khác nhau vận hành.
Distributed Systems tập trung vào việc nhiều thành phần độc lập, thường giao tiếp qua mạng, phối hợp để cung cấp một năng lực của hệ thống. Khi đó, các vấn đề như network latency, partial failure, consistency, coordination và fault tolerance trở thành những mối quan tâm quan trọng.
Ví dụ, một ứng dụng NestJS gọi API của nhà cung cấp dịch vụ chữ ký số là một bài toán tích hợp. Nếu backend được tách thành nhiều service, mỗi service triển khai độc lập và giao tiếp qua mạng, chúng ta còn phải giải quyết các vấn đề của kiến trúc phân tán.
Trong thực tế, một hệ thống có thể đồng thời chứa cả hai loại bài toán.
| Góc nhìn | System Integration | Distributed Systems |
|---|---|---|
| Mối quan tâm chính | Hợp đồng giao tiếp và phối hợp nghiệp vụ | Giao tiếp qua mạng và hành vi của nhiều thành phần độc lập |
| Giao tiếp | REST, SOAP, webhook, message broker, file exchange | RPC, message broker, event stream, giao thức nội bộ |
| Vấn đề thường gặp | Mapping dữ liệu, authentication, versioning, reconciliation | Partial failure, consistency, retry, coordination, fault tolerance |
| Câu hỏi thiết kế | Hai hệ thống có hiểu và xử lý dữ liệu giống nhau không? | Hệ thống hành xử thế nào khi một thành phần thất bại hoặc phản hồi chậm? |
Điểm tôi thấy hữu ích khi phân biệt hai khái niệm này là chúng giúp xác định đúng phạm vi của vấn đề. Không phải cứ tích hợp API là phải sử dụng microservices, và không phải cứ chia ứng dụng thành nhiều service là đã giải quyết tốt bài toán phân tán.
2. Tích hợp API: Ranh giới giữa hai hệ thống là nơi cần được thiết kế cẩn thận
Xét một ứng dụng có chức năng thanh toán trực tuyến. Backend của chúng ta gửi yêu cầu đến payment provider và chờ phản hồi.
Ở góc độ lập trình, việc gọi API có thể chỉ cần một HTTP client. Nhưng ở góc độ thiết kế hệ thống, điều quan trọng hơn là xác định chính xác ý nghĩa của từng trạng thái giao dịch và cách xử lý khi quá trình giao tiếp không diễn ra như dự kiến.
Ví dụ:
- Backend gửi yêu cầu tạo giao dịch.
- Payment provider tiếp nhận và xử lý.
- Backend chờ phản hồi nhưng bị timeout.
- Backend không biết giao dịch đã thất bại hay đã thành công nhưng phản hồi bị mất.
Đây là điểm cần chú ý: timeout không đồng nghĩa với việc thao tác ở hệ thống bên kia đã thất bại.
Nếu backend lập tức gửi lại yêu cầu mà không có cơ chế chống trùng, cùng một nghiệp vụ có thể được thực hiện nhiều lần. Với thanh toán, điều đó có thể dẫn đến hậu quả nghiêm trọng.
Một cách tiếp cận phổ biến là sử dụng idempotency key nếu nhà cung cấp hỗ trợ, đồng thời lưu trạng thái giao dịch ở backend và xác minh kết quả qua API tra cứu hoặc webhook.
Khi nhận webhook, hệ thống cũng cần xác thực nguồn gửi, kiểm tra định danh sự kiện và xử lý thông điệp trùng lặp. Không nên mặc định rằng mỗi webhook chỉ được gửi đúng một lần.
Ở đây có một số khái niệm cần phân biệt:
- Retry: Thử lại một thao tác khi lỗi có khả năng phục hồi.
- Idempotency: Đảm bảo việc thực hiện lặp lại cùng một yêu cầu không tạo ra thêm tác động nghiệp vụ ngoài dự kiến.
- Reconciliation: Đối soát dữ liệu giữa các hệ thống để phát hiện và xử lý sai lệch.
- Webhook: Cơ chế một hệ thống thông báo sự kiện đến hệ thống khác thông qua HTTP.
Chúng giải quyết những vấn đề khác nhau và thường cần phối hợp với nhau trong các luồng tích hợp quan trọng.
Một điều tôi thấy đáng lưu ý là việc xử lý lỗi nên dựa trên ngữ nghĩa nghiệp vụ, không chỉ dựa vào mã HTTP. Có những lỗi không nên retry, có những lỗi cần thử lại với backoff, và có những trường hợp phải truy vấn trạng thái giao dịch trước khi quyết định bước tiếp theo.
3. Partial failure: Khi một phần hệ thống lỗi nhưng phần còn lại vẫn hoạt động
Trong ứng dụng đơn giản chạy trên một tiến trình, chúng ta thường dễ hình dung luồng thực thi từ đầu đến cuối. Trong hệ thống phân tán, một thành phần có thể gặp sự cố trong khi những thành phần còn lại vẫn đang hoạt động.
Giả sử dịch vụ Order gọi dịch vụ Inventory để giữ hàng. Inventory xử lý yêu cầu nhưng phản hồi bị mất do lỗi mạng.
Order không thể xác định chỉ từ timeout rằng Inventory chưa thực hiện thao tác. Nếu gửi lại yêu cầu, hệ thống phải có cách đảm bảo việc giữ hàng không bị lặp ngoài ý muốn. Nếu không gửi lại, đơn hàng có thể bị treo trong trạng thái chưa xác định.
Đây là một ví dụ của partial failure: một phần của luồng xử lý không còn phản hồi như mong đợi, trong khi trạng thái thực tế của toàn hệ thống không dễ xác định.
Một số kỹ thuật thường được sử dụng để xử lý nhóm vấn đề này gồm:
Timeout: Mọi lời gọi qua mạng cần có giới hạn thời gian phù hợp. Nếu không, request có thể giữ tài nguyên quá lâu và làm tăng số lượng kết nối đang chờ.
Retry với backoff: Thử lại các lỗi tạm thời theo chính sách có giới hạn. Cần tránh retry vô hạn hoặc retry đồng loạt khiến dịch vụ đang quá tải càng chịu thêm áp lực. Jitter thường được dùng để giảm hiện tượng nhiều client cùng retry tại một thời điểm.
Circuit breaker: Tạm ngừng gọi một dịch vụ đang có dấu hiệu thất bại liên tục, giúp hạn chế việc tiếp tục tạo tải lên một thành phần đang gặp sự cố. Circuit breaker không thay thế timeout hoặc retry; nó bổ sung một cơ chế kiểm soát khác.
Bulkhead: Cô lập tài nguyên hoặc giới hạn mức độ ảnh hưởng giữa các nhóm công việc, nhằm tránh một luồng bị nghẽn kéo theo toàn bộ ứng dụng.
Các kỹ thuật này không nên được thêm vào chỉ vì chúng xuất hiện trong một danh sách best practices. Việc lựa chọn cần dựa trên đặc tính của dependency, loại lỗi có thể xảy ra và mức độ ảnh hưởng đến nghiệp vụ.
Chẳng hạn, retry một truy vấn đọc dữ liệu có thể khác đáng kể với retry một thao tác tạo giao dịch thanh toán. Với thao tác ghi, cần xem xét khả năng thực hiện trùng và cơ chế xác định kết quả trước khi quyết định thử lại.
4. Synchronous và asynchronous integration: Không chỉ là vấn đề tốc độ
Một lựa chọn thiết kế thường gặp là nên gọi trực tiếp qua HTTP hay đưa công việc vào message queue.
Giả sử sau khi tạo đơn hàng, hệ thống cần gửi email xác nhận.
Nếu gửi email đồng bộ trong cùng request, luồng xử lý có thể là:
Client
  |
  v
Order API
  |
  +----> Validate order
  |
  +----> Persist order
  |
  +----> Email Provider
  |
  v
HTTP Response
Cách này đơn giản, dễ theo dõi và có thể phù hợp với những nghiệp vụ cần phản hồi kết quả trực tiếp. Nhưng thời gian phản hồi sẽ chịu ảnh hưởng của email provider. Nếu dịch vụ này chậm hoặc không khả dụng, request tạo đơn hàng cũng có thể bị kéo dài hoặc thất bại.
Một phương án khác là đưa tác vụ gửi email sang xử lý bất đồng bộ:
Client
  |
  v
Order API
  |
  +----> Persist order
  |
  +----> Publish event
              |
              v
          Message Queue
              |
              v
          Email Worker
              |
              v
        Email Provider
Lúc này, việc gửi email không nhất thiết phải hoàn thành trước khi API phản hồi.
Tuy nhiên, asynchronous không đồng nghĩa với việc hệ thống tự động đáng tin cậy hơn. Chúng ta phải giải quyết thêm việc bảo đảm sự kiện được phát đi, worker xử lý thông điệp, retry khi lỗi, xử lý thông điệp trùng và theo dõi những tác vụ chưa hoàn tất.
Một vấn đề kinh điển là backend đã commit dữ liệu đơn hàng vào database nhưng gặp lỗi trước khi publish event. Đơn hàng tồn tại, nhưng email không bao giờ được gửi vì sự kiện chưa được tạo thành công.
Transactional Outbox là một phương án thường được dùng cho trường hợp này: ghi dữ liệu nghiệp vụ và bản ghi sự kiện vào cùng một database transaction, sau đó một tiến trình riêng phát các sự kiện chưa được gửi. Consumer vẫn cần idempotency vì sự kiện có thể được phát hoặc nhận nhiều lần.
Cần lưu ý rằng Outbox giải quyết một phần vấn đề nhất quán giữa database và việc phát sự kiện; nó không tự động đảm bảo mọi bước downstream thành công.
Với những luồng nghiệp vụ dài hơn, chúng ta còn cần xác định trạng thái xử lý, chính sách retry, khả năng bù trừ và cách vận hành khi một bước không thể hoàn tất.
5. Eventual consistency và giới hạn của transaction
Trong một ứng dụng sử dụng một relational database, chúng ta có thể dựa vào transaction để đảm bảo nhiều thao tác dữ liệu được commit hoặc rollback cùng nhau.
Nhưng khi một nghiệp vụ đi qua nhiều service, mỗi service có database riêng, một transaction cục bộ không thể tự động bao phủ toàn bộ các hệ thống đó.
Ví dụ, việc tạo đơn hàng có thể thành công ở Order Service nhưng việc giữ hàng ở Inventory Service thất bại. Hai thành phần không nhất thiết có thể cùng rollback bằng một transaction database thông thường.
Một phương án là sử dụng Saga: biểu diễn nghiệp vụ thành một chuỗi bước cục bộ, mỗi bước có hành động bù trừ phù hợp khi quy trình không thể tiếp tục.
Chẳng hạn:
- Tạo đơn hàng ở trạng thái chờ xử lý.
- Yêu cầu giữ hàng.
- Thực hiện thanh toán.
- Xác nhận đơn hàng.
Nếu thanh toán thất bại sau khi hàng đã được giữ, hệ thống có thể yêu cầu giải phóng lượng hàng đó. Đây là hành động bù trừ, không nhất thiết là rollback nguyên tử như transaction trong một database.
Saga có thể được triển khai theo kiểu choreography, nơi các thành phần phản ứng với sự kiện của nhau, hoặc orchestration, nơi một thành phần điều phối tiến trình.
Mỗi cách có ưu và nhược điểm riêng. Choreography giảm sự phụ thuộc vào một bộ điều phối trung tâm nhưng có thể khiến luồng nghiệp vụ khó theo dõi khi số lượng sự kiện tăng lên. Orchestration giúp biểu diễn tiến trình rõ hơn nhưng cần quản lý trách nhiệm và trạng thái của bộ điều phối.
Eventual consistency cũng thường xuất hiện trong những kiến trúc này. Dữ liệu giữa các thành phần có thể chưa đồng nhất ngay sau một thao tác, nhưng được kỳ vọng hội tụ khi các bước đồng bộ hoàn tất.
Điều quan trọng là không nên mặc định eventual consistency phù hợp với mọi nghiệp vụ. Đội ngũ cần xác định dữ liệu nào được phép trễ, trạng thái nào người dùng có thể nhìn thấy trong thời gian chờ và cách xử lý khi việc đồng bộ thất bại kéo dài.
Đây là những quyết định nghiệp vụ lẫn kỹ thuật, không chỉ là lựa chọn một message broker.
6. Observability: Khi log của từng service chưa đủ để giải thích một vấn đề
Trong một hệ thống gồm nhiều service, việc mở log của từng thành phần đôi khi không đủ để hiểu một request đã đi qua những đâu và thất bại ở bước nào.
Giả sử người dùng phản ánh rằng đơn hàng đã tạo nhưng trạng thái thanh toán không cập nhật. Luồng xử lý có thể đi qua Order API, Payment Service, một message broker và worker xử lý webhook.
Nếu mỗi thành phần ghi log theo cách khác nhau, không có correlation ID hoặc thiếu thông tin định danh giao dịch, việc truy tìm nguyên nhân sẽ tốn nhiều thời gian.
Đó là lý do observability trở nên quan trọng.
Ba nhóm tín hiệu thường được nhắc đến là:
- Logs: Ghi lại các sự kiện và thông tin cần thiết để điều tra.
- Metrics: Theo dõi các chỉ số như request rate, latency, error rate, queue depth và số lần retry.
- Traces: Thể hiện một luồng xử lý qua nhiều thành phần, giúp xác định thời gian và vị trí phát sinh vấn đề.
Correlation ID hoặc trace context có thể được truyền qua các lời gọi và thông điệp để liên kết những phần của cùng một luồng nghiệp vụ.
Với hệ thống có xử lý bất đồng bộ, việc truy vết còn cần gắn được sự kiện được phát với consumer tương ứng, thay vì chỉ dựa vào vòng đời của một HTTP request.
Observability không chỉ dành cho những hệ thống rất lớn. Ngay cả một backend nhỏ có tích hợp nhiều dịch vụ bên ngoài cũng có thể hưởng lợi từ log có cấu trúc, định danh giao dịch rõ ràng và một số metrics cơ bản.
Tất nhiên, logging cũng cần chú ý đến bảo mật: không ghi token, secret hoặc dữ liệu cá nhân nhạy cảm một cách tùy tiện.
7. Khi nào nên tách service, khi nào nên giữ modular monolith?
Từ những vấn đề trên, có thể thấy việc tách một ứng dụng thành nhiều service không chỉ thay đổi cách tổ chức source code. Nó tạo ra thêm những ranh giới giao tiếp qua mạng và kéo theo các vấn đề về dữ liệu, triển khai, giám sát và xử lý sự cố.
Một modular monolith vẫn có thể có module rõ ràng, dependency được kiểm soát và các ranh giới nghiệp vụ tương đối độc lập. Các module có thể gọi nhau trong cùng tiến trình, giảm đáng kể độ phức tạp vận hành so với việc giao tiếp qua mạng.
Việc tách service có thể đáng cân nhắc khi xuất hiện những nhu cầu thực tế như:
- Một thành phần cần scale độc lập với phần còn lại.
- Các nhóm cần quyền sở hữu và lịch phát hành độc lập.
- Một thành phần có yêu cầu tài nguyên hoặc công nghệ rất khác biệt.
- Ranh giới dữ liệu và nghiệp vụ đủ rõ để quản lý độc lập.
- Yêu cầu về độ sẵn sàng hoặc cách cô lập sự cố không phù hợp với một tiến trình chung.
Ngay cả khi những nhu cầu đó xuất hiện, việc tách service vẫn cần đánh giá chi phí giao tiếp mạng, độ phức tạp dữ liệu và năng lực vận hành của đội ngũ.
Tôi nghĩ đây là một trong những điểm đáng lưu ý khi học kiến trúc: một quyết định có thể làm hệ thống tốt hơn ở một khía cạnh nhưng đồng thời tạo ra chi phí ở những khía cạnh khác.
Không có lợi ích nào đến miễn phí. Điều quan trọng là hiểu rõ mình đang đánh đổi điều gì.
8. Cách tôi nghĩ developer mới có thể tiếp cận những chủ đề này
Với những bạn đang học backend bằng Node.js, tôi nghĩ không cần bắt đầu bằng một hệ thống microservices phức tạp.
Hãy xây dựng một ứng dụng đủ nhỏ để có thể hiểu toàn bộ luồng xử lý, nhưng đủ thực tế để phát sinh những vấn đề cần giải quyết.
Một hướng thực hành có thể là:
- Xây dựng API quản lý đơn hàng bằng Express.js hoặc NestJS, sử dụng PostgreSQL.
- Tích hợp một dịch vụ bên ngoài và xử lý timeout, lỗi xác thực, giới hạn tốc độ và phản hồi không hợp lệ.
- Thêm worker để xử lý tác vụ bất đồng bộ, sử dụng một message queue phù hợp.
- Thiết kế cơ chế retry có giới hạn và idempotency cho consumer.
- Tạo tình huống database đã commit nhưng việc publish event thất bại, sau đó tìm hiểu Transactional Outbox.
- Bổ sung log có cấu trúc, correlation ID và metrics để theo dõi luồng xử lý.
- Cuối cùng, thử tách một module thành service riêng và so sánh chi phí, lợi ích với phương án giữ trong cùng ứng dụng.
Điều quan trọng là sau mỗi bước, hãy tự tạo ra tình huống lỗi và quan sát hành vi của hệ thống.
Nếu chỉ triển khai trường hợp mọi thứ đều thành công, chúng ta mới hiểu được luồng xử lý bình thường. Nhưng khi làm phần mềm vận hành thực tế, phần lớn những quyết định khó nằm ở việc xác định hệ thống phải phản ứng thế nào khi một điều kiện không còn đúng như dự kiến.
Kết luận
Tôi vẫn đang tiếp tục tìm hiểu những vấn đề liên quan đến thiết kế và vận hành hệ thống. Nhưng có một điều ngày càng rõ với tôi: khi phần mềm có nhiều thành phần độc lập, việc làm cho từng thành phần hoạt động đúng chỉ là một phần của bài toán.
Chúng ta còn phải quan tâm đến hợp đồng giao tiếp, tính nhất quán của dữ liệu, khả năng phục hồi sau lỗi và cách quan sát toàn bộ luồng xử lý.
System Integration giúp các hệ thống trao đổi dữ liệu và phối hợp nghiệp vụ. Distributed Systems đặt ra những vấn đề sâu hơn về việc nhiều thành phần độc lập vận hành qua mạng. Khi kết hợp hai lĩnh vực này, những chi tiết như timeout, retry, idempotency, eventual consistency và observability không còn là những thuật ngữ riêng lẻ, mà trở thành các quyết định thiết kế có liên quan trực tiếp đến độ tin cậy của sản phẩm.
Tôi nghĩ developer không cần vội áp dụng tất cả những kỹ thuật trên vào mọi dự án. Điều cần thiết hơn là hiểu chúng giải quyết vấn đề gì, giới hạn của chúng nằm ở đâu và khi nào chi phí áp dụng trở nên hợp lý.
Khi một hệ thống không còn nằm gọn trong một ứng dụng, bài toán không chỉ là kết nối các thành phần. Bài toán là thiết kế cách chúng phối hợp, phát hiện sai lệch và phục hồi khi một phần của hệ thống không hoạt động như mong đợi.
Đó là góc nhìn tôi muốn tiếp tục đào sâu trong quá trình phát triển phần mềm.